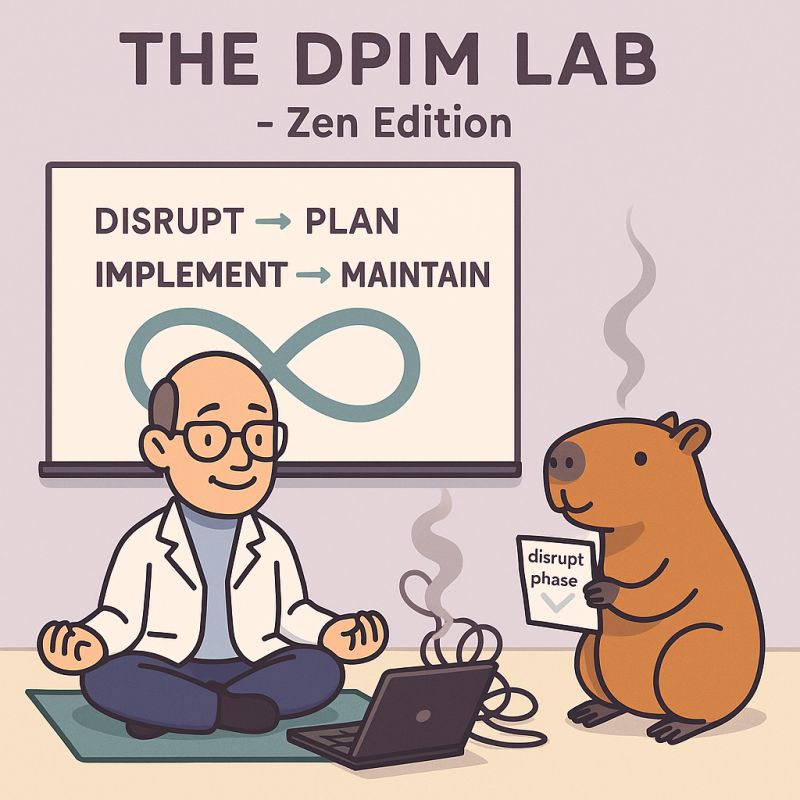
DPIM Framework: La Mia Metodologia di Lavoro
Dopo anni passati a navigare progetti IT, migrazioni disastrose, implementazioni d’urgenza e manutenzioni infinite, ho sviluppato un framework personale che mi guida in ogni progetto.
Lo chiamo DPIM: Disrupt, Plan, Implement, Maintain.
Non è una metodologia accademica. Non troverai paper su questo. È semplicemente il modo in cui funziono meglio.
D - Disrupt (Analisi Disruptiva)
Prima di fare qualsiasi cosa, rompo lo schema.
Cosa significa
Non accetto il problema così come mi viene presentato. Lo smonto. Lo guardo da angolazioni diverse. Mi chiedo:
- Stiamo risolvendo il problema giusto?
- Questo problema esiste davvero o è un sintomo?
- C’è un modo completamente diverso di affrontarlo?
- Cosa succederebbe se NON lo facessimo?
Esempio pratico
Richiesta: “Ci serve un server più potente, il sistema è lento.”
Fase Disrupt:
- Analizzo i log: il 90% del tempo è speso in query al DB
- Scopro che c’è un indice mancante
- Soluzione: Aggiungo un indice invece di comprare hardware
Risultato: €0 spesi, 10x performance.
Perché funziona
Perché troppo spesso si cerca di risolvere velocemente, senza capire. La fase Disrupt rallenta intenzionalmente per evitare di sprecare tempo su soluzioni sbagliate.
Modalità capibara: calma e osservazione prima dell’azione.
P - Plan (Pianificazione Pragmatica)
Una volta capito il vero problema, pianifico. Ma non con Gantt infiniti e task suddivisi in sotto-sotto-task.
Cosa significa
Pianificazione pragmatica:
- Obiettivo chiaro: dove vogliamo arrivare?
- Milestone verificabili: punti di controllo concreti
- Rischi identificati: cosa può andare storto?
- Rollback plan: se salta tutto, come torniamo indietro?
Strumenti che uso
- Checklist semplici: niente tool complessi, solo liste
- Diagrammi essenziali: l’architettura in 3 box e 5 frecce
- Documentazione minima: README e runbook, stop
Esempio pratico
Progetto: Migrazione da VM a Docker
Piano:
- Milestone 1: Container in test con DB mockato
- Milestone 2: Container in staging con DB reale
- Milestone 3: Blue-green deployment in produzione
- Rollback: Immagine VM ready, switch DNS immediato
Rischi identificati:
- Volumi persistenti non mappati → test pre-prod obbligatorio
- Variabili d’ambiente mancanti → checklist validazione
Perché funziona
Perché pianificare tutto è paralisi. Pianificare niente è caos. La via di mezzo è pianificare l’essenziale.
Modalità capibara: preparazione sufficiente, non perfetta.
I - Implement (Implementazione Iterativa)
Qui si fa. Ma non tutto insieme. Un pezzo alla volta.
Cosa significa
Implementazione iterativa:
- Deploy piccoli e frequenti: meglio 10 deploy da 1 feature che 1 deploy da 10 feature
- Test continuo: ogni pezzo deve funzionare prima di passare al prossimo
- Feedback rapido: se qualcosa non va, lo scopro subito
- Documentazione parallela: scrivo mentre faccio, non alla fine
Esempio pratico
Progetto: Automazione deploy con CI/CD
Iterazioni:
- Script base che fa build locale → funziona? ✓
- Script che pusha su registry → funziona? ✓
- Pipeline CI che esegue lo script → funziona? ✓
- Deploy automatico in staging → funziona? ✓
- Deploy manuale in produzione → funziona? ✓
- Deploy automatico in produzione → funziona? ✓
Ogni passo è verificabile. Ogni passo aggiunge valore.
Perché funziona
Perché implementare tutto insieme e debuggare poi è un incubo. Implementare un pezzo, verificare, passare al prossimo è sostenibile.
Modalità capibara: un passo alla volta, con calma.
M - Maintain (Manutenzione Preventiva)
Il progetto è in produzione. Funziona. Non ho finito.
Cosa significa
Manutenzione preventiva:
- Monitoring attivo: non aspetto che si rompa, monitoro segnali deboli
- Documentazione aggiornata: se cambio qualcosa, aggiorno il runbook
- Debt management: dedico tempo a ripagare il debito tecnico
- Post-mortem: se qualcosa va storto, analizzo e imparo
Strumenti che uso
- Alerting intelligente: solo alert che richiedono azione
- Log aggregation: tutto in un posto, ricercabile
- Backup testati: backup che non testi è backup che non hai
- Runbook evolutivo: documento che cresce con il progetto
Esempio pratico
Progetto: API in produzione
Manutenzione:
- Monitoring: Tempo risposta, error rate, uso risorse
- Alert: Solo se > 5% errori o > 1s latenza media
- Review settimanale: Controllo log, cerco pattern strani
- Update mensile: Dipendenze, security patch
Risultato: 0 downtime non pianificati in 8 mesi.
Perché funziona
Perché un sistema senza manutenzione è un sistema che sta già degradando. La manutenzione preventiva è rispetto per il futuro te.
Modalità capibara: cura costante, non interventi d’emergenza.
Il ciclo completo
DPIM non è lineare. È ciclico.
Disrupt → Plan → Implement → Maintain
    ↑                            ↓
    ←←←←←← (feedback loop) ←←←←←←
Durante il Maintain, potrei scoprire che serve un nuovo Disrupt.
Durante l’Implement, potrei dover rifare parte del Plan.
È flessibile, non rigido.
Quando uso DPIM
Sempre.
- Migrazione infrastrutturale? DPIM.
- Bug critico in produzione? DPIM (versione veloce).
- Nuovo progetto da zero? DPIM.
- Refactoring codice legacy? DPIM.
Quando NON uso DPIM
Quando il problema è banale e la soluzione ovvia.
Se devo riavviare un servizio in crash, non faccio Disrupt analysis. Lo riavvio. Pragmatismo first.
Il mindset dietro DPIM
DPIM non è solo un processo. È un mindset:
- Disrupt: Curiosità e pensiero critico
- Plan: Pragmatismo e preparazione
- Implement: Azione iterativa e feedback
- Maintain: Responsabilità e lungimiranza
È, in essenza, modalità capibara applicata al lavoro IT.
Provalo
Non devi chiamarlo DPIM. Non devi seguirlo alla lettera.
Ma prova questo:
- Prima di agire, capisci davvero il problema
- Pianifica l’essenziale, non tutto
- Implementa un pezzo alla volta
- Prenditi cura di ciò che hai creato
Vedrai che i progetti diventano più sostenibili, meno caotici, più prevedibili.
E tu sarai più calmo.
DPIM Framework è il mio modo di lavorare. Qual è il tuo?
🦫
Più info su DPIM Framework: middei.info/dpim